Durante décadas, el llamado código de la Biblia ha alimentado una de las controversias más fascinantes entre religión, matemáticas y misterio. La idea resulta tan sencilla como inquietante: que determinadas palabras, nombres y acontecimientos podrían encontrarse ocultos dentro del texto hebreo de la Biblia mediante patrones matemáticos basados en la selección de letras a intervalos regulares. La hipótesis adquirió enorme popularidad durante la década de 1990, especialmente después de los trabajos de Eliyahu Rips, Doron Witztum y Yoav Rosenberg, y posteriormente gracias al periodista Michael Drosnin. Sin embargo, detrás de la fascinación por esos supuestos mensajes existe una cuestión mucho más compleja: ¿estamos ante información codificada deliberadamente o ante patrones que pueden aparecer cuando buscamos entre cantidades enormes de combinaciones?
La historia del código bíblico resulta especialmente interesante porque mezcla elementos muy diferentes. Por un lado están los experimentos estadísticos publicados en revistas académicas; por otro, las interpretaciones religiosas y las afirmaciones sobre acontecimientos futuros; y, finalmente, las críticas de otros matemáticos y estadísticos que cuestionaron la metodología empleada. A esto se añade un elemento todavía más antiguo: la existencia de sistemas reales de cifrado en textos hebreos, como el Atbash, utilizado en determinados pasajes del Libro de Jeremías. La diferencia entre ambos fenómenos es fundamental: una cosa es encontrar patrones matemáticos después de buscar entre millones de posibilidades y otra muy distinta es utilizar conscientemente un sistema de sustitución de letras.
Cómo nació la idea del código de la Biblia
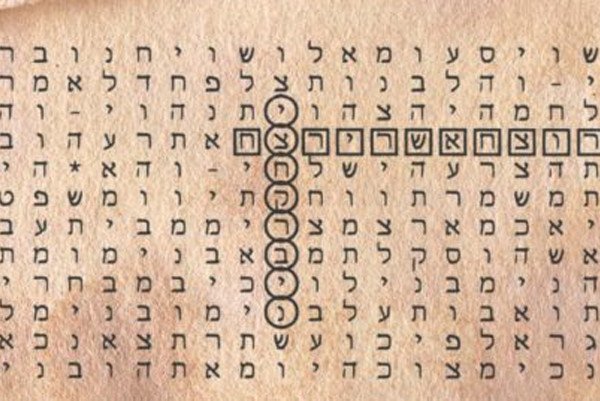
La historia moderna del código de la Biblia está relacionada principalmente con el texto hebreo de la Torá, especialmente con el Génesis. El procedimiento conocido como secuencias de letras equidistantes, o ELS por sus siglas en inglés, consiste básicamente en seleccionar letras separadas por un determinado número de posiciones dentro de un texto. Dependiendo del intervalo elegido, pueden aparecer palabras que, posteriormente, se interpretan como nombres o conceptos relacionados entre sí.
La idea no nació completamente con los ordenadores modernos. La búsqueda de patrones dentro de textos religiosos tiene una historia mucho más antigua, relacionada con distintas tradiciones de interpretación del texto hebreo. Sin embargo, la informática permitió realizar búsquedas a una velocidad que habría sido imposible para un investigador humano. Un texto podía convertirse en una enorme matriz de letras y un programa podía examinar miles o millones de combinaciones en cuestión de segundos.
La posibilidad resultaba extraordinariamente atractiva. Si determinadas palabras aparecían próximas entre sí dentro del texto, algunos investigadores se preguntaron si esa proximidad podía ser estadísticamente significativa. El problema consistía en determinar cuándo un patrón era realmente extraordinario y cuándo era simplemente el resultado inevitable de buscar dentro de una cantidad gigantesca de combinaciones.
Ahí comenzó el verdadero experimento científico.
Eliyahu Rips y el experimento de los grandes rabinos
En 1994, Eliyahu Rips, Doron Witztum y Yoav Rosenberg publicaron en Statistical Science un estudio titulado Equidistant Letter Sequences in the Book of Genesis. Su investigación examinaba si los nombres de determinados rabinos famosos y sus fechas de nacimiento y muerte presentaban una proximidad estadística dentro del texto hebreo del Génesis.
El experimento no consistía simplemente en encontrar una palabra aislada. Los investigadores utilizaron un procedimiento matemático para buscar secuencias de letras equidistantes y analizar después la relación espacial entre diferentes términos. El resultado publicado fue interpretado por sus autores como evidencia estadísticamente significativa de que aquellos nombres y fechas aparecían juntos con una frecuencia difícil de explicar únicamente mediante el azar.
La publicación provocó una enorme repercusión. Para quienes defendían la hipótesis, aquel resultado parecía sugerir que el texto bíblico contenía información estructurada que no podía atribuirse fácilmente a la casualidad. Para otros investigadores, sin embargo, la cuestión no era si podían encontrarse patrones, sino si el diseño experimental utilizado permitía demostrar que esos patrones eran realmente excepcionales.
La diferencia parece pequeña, pero resulta fundamental. Encontrar una combinación llamativa dentro de un texto enorme no demuestra por sí mismo que esa combinación haya sido colocada deliberadamente. Para demostrarlo sería necesario establecer previamente unas reglas claras y comprobar que el resultado se mantiene cuando esas reglas se aplican sin modificaciones posteriores.
Ese punto se convertiría posteriormente en el centro de la controversia.
Michael Drosnin y las supuestas profecías ocultas
El fenómeno abandonó rápidamente el ámbito académico y llegó al gran público gracias al periodista Michael Drosnin. En 1997 publicó El código secreto de la Biblia, un libro que convirtió la hipótesis matemática en un fenómeno internacional. Drosnin no se limitó a analizar nombres de rabinos: buscó acontecimientos históricos, personajes famosos y posibles acontecimientos futuros.
Uno de los episodios más conocidos fue el asesinato del primer ministro israelí Isaac Rabin. Rabin fue asesinado el 4 de noviembre de 1995 por Yigal Amir, y Drosnin afirmó posteriormente que había encontrado su nombre relacionado mediante el sistema de secuencias equidistantes con referencias a su asesinato. La existencia del asesinato es un hecho histórico; la interpretación de que el texto bíblico lo había predicho mediante un código es, en cambio, una afirmación controvertida atribuida a Drosnin.
Este episodio fue especialmente poderoso desde el punto de vista narrativo porque parecía convertir una teoría matemática en una predicción real. El problema era que, una vez ocurrido el acontecimiento, siempre era posible regresar al texto y buscar combinaciones que parecieran relacionadas con él.
La pregunta entonces cambió. Ya no era simplemente si podían encontrarse palabras dentro de la Biblia.
La pregunta era si podían encontrarse antes de que ocurriera un acontecimiento, siguiendo unas reglas establecidas previamente. Esa diferencia es esencial para evaluar cualquier supuesto sistema de predicción.
El gran problema: millones de combinaciones posibles
Imaginemos un texto formado por cientos de miles de letras. Ahora imaginemos que podemos comenzar a seleccionar letras desde diferentes posiciones y utilizar numerosos intervalos: dos letras, tres, cuatro, cinco, diez, veinte o cualquier otra distancia. Además, podemos buscar palabras en diferentes direcciones y combinar posteriormente los resultados.
Las posibilidades crecen de manera extraordinaria.
En ese escenario es prácticamente inevitable encontrar coincidencias llamativas. Podemos seleccionar nombres, fechas, ciudades, guerras, enfermedades, políticos o acontecimientos históricos y buscar posteriormente relaciones entre ellos. Cuantas más cosas busquemos, mayor será la posibilidad de encontrar alguna combinación que parezca extraordinaria.
Este problema está relacionado con una cuestión fundamental de la estadística: las comparaciones múltiples. Cuando se realizan muchísimas búsquedas, algunos resultados aparentemente improbables pueden aparecer simplemente por azar.
Por eso, en un experimento científico resulta tan importante definir las condiciones antes de realizar la búsqueda. Si primero encontramos un patrón y después modificamos las reglas hasta conseguir otro resultado todavía más llamativo, ya no estamos realizando una prueba completamente independiente.
Esta cuestión fue precisamente una de las principales críticas dirigidas contra los experimentos del código bíblico.
Moby-Dick y el desafío que puso a prueba la teoría
Uno de los episodios más famosos de la controversia llegó cuando el matemático Brendan McKay utilizó un procedimiento relacionado con el de los códigos bíblicos sobre otra obra literaria: Moby-Dick, la novela de Herman Melville.
El resultado fue inquietante.
Aplicando técnicas similares, McKay y otros investigadores encontraron supuestas referencias relacionadas con asesinatos históricos. El objetivo no era demostrar que Melville hubiera predicho esos acontecimientos, sino precisamente mostrar que podían aparecer patrones aparentemente sorprendentes cuando se dispone de un texto suficientemente grande y se buscan relaciones de manera flexible.
El experimento se convirtió en una poderosa ilustración del problema. Si un procedimiento capaz de encontrar acontecimientos aparentemente proféticos en la Biblia también podía producir resultados similares en una novela que no tenía ninguna relación con esos acontecimientos, entonces era necesario analizar con mucho más cuidado qué parte del fenómeno procedía de la estructura del texto y qué parte procedía del método de búsqueda.
La polémica llegó nuevamente a Statistical Science en 1999, cuando Brendan McKay, Dror Bar-Natan, Maya Bar-Hillel y Gil Kalai publicaron una crítica del experimento original. Su trabajo sostuvo que existían problemas importantes relacionados con el diseño experimental y la selección de los datos.
La controversia no desapareció inmediatamente. Los defensores del código bíblico continuaron realizando nuevos experimentos y presentando resultados, mientras que sus críticos siguieron señalando problemas metodológicos y la facilidad con la que pueden aparecer coincidencias cuando se realizan suficientes búsquedas.
¿Puede un código encontrar acontecimientos futuros?
Aquí aparece probablemente la afirmación más extraordinaria asociada al código de la Biblia: la posibilidad de que el texto contenga información sobre acontecimientos todavía no ocurridos.
El planteamiento resulta fascinante, pero científicamente presenta una dificultad enorme. Una predicción debe poder formularse antes de que ocurra el acontecimiento y utilizando unas reglas que no hayan sido modificadas después de conocer el resultado.
Si sabemos que una persona será asesinada y posteriormente buscamos su nombre junto a palabras como “muerte”, “asesino”, “año” o “guerra”, tendremos muchas más posibilidades de encontrar alguna combinación llamativa.
Pero si establecemos previamente qué palabras debemos buscar, qué intervalos utilizaremos y qué resultado consideraremos estadísticamente significativo, el experimento adquiere una estructura completamente diferente.
Esta es una de las razones por las que las supuestas predicciones del código bíblico han generado tanta controversia. El hecho de que un acontecimiento pueda relacionarse posteriormente con determinadas secuencias no demuestra por sí mismo que esas secuencias hayan predicho el acontecimiento.
La diferencia entre predicción previa e interpretación posterior es fundamental.
El hebreo y el enorme margen de interpretación
Existe además otro problema relacionado con la propia naturaleza de los textos hebreos antiguos. La escritura hebrea tradicional utiliza un sistema consonántico en el que las vocales pueden no aparecer representadas de la misma manera que en una escritura moderna como el español.
Esto significa que determinados términos pueden admitir diferentes lecturas y transliteraciones dependiendo del contexto, de la tradición textual y del sistema utilizado para representar las palabras.
Cuando se combina esta característica con búsquedas informáticas masivas, el número de posibilidades puede aumentar todavía más.
Por eso, encontrar una secuencia que pueda interpretarse como un nombre concreto no significa automáticamente que el autor original hubiera querido transmitir ese nombre.
La cuestión vuelve a ser la misma: ¿las reglas fueron establecidas antes de encontrar el resultado o después?
Si las reglas se conocen previamente y el resultado aparece de manera estadísticamente significativa, la observación puede someterse a una prueba rigurosa. Si las reglas se modifican después de descubrir el resultado, aumenta el riesgo de encontrar patrones simplemente porque estamos buscando hasta que alguno encaje.
El código Atbash: un misterio bíblico diferente
Aquí aparece uno de los aspectos más fascinantes de toda esta historia: sí existen ejemplos documentados de cifrado dentro de textos hebreos antiguos.
Uno de los más conocidos es Atbash, un sistema de sustitución en el que las letras se intercambian siguiendo una correspondencia inversa dentro del alfabeto hebreo. La primera letra se sustituye por la última, la segunda por la penúltima y así sucesivamente.
Este procedimiento es completamente diferente de las secuencias de letras equidistantes del supuesto código bíblico moderno.
En Atbash existe una regla concreta de transformación. No se trata de buscar posteriormente palabras escondidas dentro de millones de combinaciones posibles. Si conocemos el sistema, podemos aplicarlo de manera directa.
Uno de los ejemplos más conocidos aparece en el Libro de Jeremías, donde aparece el término Sheshach, tradicionalmente relacionado mediante Atbash con Babilonia. El método está documentado como una forma de sustitución de letras hebreas.
Y aquí encontramos una diferencia esencial. En el caso de Atbash podemos identificar una regla de cifrado concreta y reproducible.
En cambio, en el caso de las secuencias equidistantes, la discusión se centra en si las coincidencias encontradas constituyen información codificada intencionadamente o patrones estadísticos que aparecen al realizar búsquedas suficientemente amplias.
¿Jeremías utilizó el código para ocultar Babilonia?
El ejemplo de Atbash relacionado con Jeremías y Babilonia ha generado también numerosas interpretaciones. El profeta vivió durante uno de los periodos más turbulentos de la historia de Judá y sus escritos están profundamente relacionados con la amenaza y posterior dominio de Babilonia.
La utilización de un término cifrado para referirse a Babilonia resulta especialmente interesante porque demuestra que los autores y tradiciones textuales del mundo antiguo conocían procedimientos de sustitución de letras.
Sin embargo, debemos evitar dar un paso que la evidencia no permite demostrar automáticamente.
Que Atbash exista y aparezca en Jeremías no demuestra que todos los demás patrones matemáticos encontrados posteriormente en la Biblia hayan sido creados mediante un sistema secreto.
Son fenómenos diferentes.
Uno utiliza una regla explícita de sustitución.
El otro depende de la selección de letras a intervalos determinados y de la interpretación estadística de las coincidencias.
Precisamente por eso, el caso de Atbash resulta tan interesante para comprender dónde termina la criptografía histórica y dónde comienza la interpretación moderna del texto.
Dos formas completamente diferentes de entender un código
Podemos imaginar dos escenarios.
En el primero, alguien escribe deliberadamente un mensaje utilizando una regla concreta. El receptor conoce esa regla y puede recuperar el mensaje siguiendo exactamente el procedimiento establecido. Eso es criptografía.
En el segundo, tenemos un texto enorme y buscamos palabras utilizando miles de combinaciones posibles. Cuando encontramos una coincidencia llamativa, interpretamos que puede contener un mensaje.
El resultado visual puede parecer similar, pero matemáticamente son situaciones completamente diferentes.
Esta distinción es especialmente importante cuando hablamos de textos religiosos porque la dimensión espiritual puede añadir otra capa de interpretación. Para una persona creyente, encontrar una coincidencia extraordinaria puede tener un significado religioso independientemente de que pueda demostrarse científicamente.
Para un estadístico, en cambio, la cuestión principal será determinar cuál era la probabilidad de obtener ese resultado bajo unas condiciones previamente establecidas.
Para un investigador del misterio, ambas perspectivas pueden resultar interesantes siempre que no confundamos una interpretación con una demostración.
Y precisamente esa frontera es la que hace que el código de la Biblia siga siendo un tema tan fascinante.
El premio Ig Nobel y el final de una fiebre
La controversia alcanzó tal popularidad que en 1997 Eliyahu Rips, Doron Witztum, Yoav Rosenberg y Michael Drosnin recibieron conjuntamente el Ig Nobel de Literatura, un reconocimiento conocido por destacar investigaciones y trabajos que primero hacen reír y después invitan a pensar. La concesión se convirtió en uno de los episodios más curiosos de la historia del código bíblico.
Para entonces, el fenómeno ya había abandonado completamente el reducido ámbito de los estudios matemáticos y se había convertido en un fenómeno cultural. Libros, programas informáticos y documentales comenzaron a presentar la idea de que la Biblia podía contener información codificada sobre acontecimientos históricos y futuros.
Pero el debate académico continuó.
Las críticas no demostraban necesariamente que jamás pudiera existir ninguna estructura matemática interesante dentro del texto bíblico. Lo que cuestionaban era que los resultados obtenidos permitieran concluir que esos patrones constituían mensajes sobrenaturales o predicciones del futuro.
Esta diferencia es importante porque una crítica estadística a un experimento concreto no equivale automáticamente a demostrar que absolutamente ningún patrón pueda existir en el texto.
Lo que se pone en duda es la interpretación que se hace de esos patrones y la metodología utilizada para demostrar que no son fruto del azar o de la selección de datos.
El código de la Biblia y nuestra necesidad de encontrar patrones
Quizá el aspecto más profundo de esta historia no esté realmente en la Biblia, sino en nosotros.
El cerebro humano está extraordinariamente preparado para detectar patrones. Encontramos formas en las nubes, reconocemos rostros donde solo existen manchas y relacionamos acontecimientos que aparentemente están separados.
Esta capacidad ha sido fundamental para la supervivencia humana.
El problema aparece cuando utilizamos esa misma capacidad sobre conjuntos de datos gigantescos.
Cuanto mayor es la cantidad de información disponible, mayor es también la posibilidad de encontrar coincidencias sorprendentes.
Hoy vivimos rodeados de enormes cantidades de datos y utilizamos programas informáticos capaces de realizar búsquedas imposibles para un ser humano. En cierto sentido, la controversia del código bíblico anticipó una pregunta que ahora resulta todavía más relevante: cuando una máquina encuentra un patrón, ¿está descubriendo una relación real o simplemente encontrando una coincidencia entre millones de posibilidades?
La pregunta es especialmente interesante en una época en la que la inteligencia artificial puede analizar cantidades gigantescas de información y descubrir relaciones que para nosotros pasarían completamente desapercibidas.
Pero descubrir una correlación no significa automáticamente descubrir una causa.
Y encontrar una coincidencia tampoco significa necesariamente encontrar un mensaje.
El verdadero misterio detrás del código de la Biblia
El código de la Biblia continúa situado en una zona fascinante entre la religión, las matemáticas, la estadística, la criptografía y el misterio. Los experimentos de Rips, Witztum y Rosenberg demostraron que podían encontrarse determinados patrones estadísticos en el texto del Génesis, pero las conclusiones extraídas de aquellos resultados fueron posteriormente objeto de importantes críticas metodológicas.
Michael Drosnin llevó la idea mucho más lejos al interpretar determinadas secuencias como referencias a acontecimientos históricos y futuros. El caso de Yitzhak Rabin se convirtió en uno de los ejemplos más conocidos, aunque la afirmación de que su asesinato fue realmente predicho mediante el código continúa siendo una interpretación controvertida y no un hecho científico establecido.
Al mismo tiempo, ejemplos como Atbash demuestran que los textos hebreos antiguos sí pueden contener mecanismos de cifrado reales. Pero reconocer la existencia de una criptografía antigua no permite concluir automáticamente que las secuencias equidistantes modernas constituyan un código deliberadamente diseñado.
Y quizá ahí se encuentre el verdadero misterio.
No necesariamente en demostrar que existe una profecía escondida entre las letras, sino en comprender hasta dónde puede llegar nuestra capacidad para encontrar significado cuando tenemos millones de combinaciones a nuestra disposición.
Tal vez algunas coincidencias sean simplemente eso: coincidencias.
Tal vez otras merezcan una investigación matemática mucho más profunda.
Y para quienes contemplan estos textos desde una perspectiva religiosa, quizá el significado del mensaje no dependa exclusivamente de que pueda demostrarse mediante una fórmula estadística.
Lo que sí sabemos es que la búsqueda continúa.
Y mientras existan personas dispuestas a recorrer letra por letra los textos antiguos en busca de respuestas, el supuesto código secreto de la Biblia seguirá planteando una pregunta tan inquietante como difícil de responder:
¿Estamos descubriendo mensajes que siempre estuvieron ahí o somos nosotros quienes los estamos creando al buscarlos?
Para continuar explorando otros enigmas relacionados con textos religiosos, puedes visitar la sección de Misterios de la Religión de Dimensión Paranormal, donde encontrarás investigaciones sobre otros grandes enigmas de la historia religiosa. También puedes descubrir nuestro artículo sobre los Manuscritos del Mar Muerto, uno de los grandes hallazgos relacionados con la historia de los textos bíblicos.